mardi 9 février 2016

PC Desktop Fanless 3/3 - Assemblage et test

Troisième et dernier épisode de fin de mes aventures au pays du fanless

Premier épisode : le cahier des charges et le choix de la solution 
Second épisode : réception du boiter HDPLEX


1er contretemps

Deux caloducs trop long sur la gauche
J'ai commencé l'assemblage et je suis tombé sur un os.

Deux des quatre caloducs orientés vers le fond du boitier (angle à gauche) se sont avérés trop longs, ils dépassent du fond du boitier.

Renseignement pris auprès du fournisseur, le problème a été rencontré également avec d'autres personnes ayant opté pour une carte mère au format micro-ATX.

Je ne saurais dire si c'est un problème de conception, ou si le problème est aléatoire en fonction des cartes mères (le plus probable cependant). Comme je ne pense pas que la norme micro-ATX aille jusque spécifier la distance du socket depuis les bords de la carte, le problème ne pouvait pas être anticipé. Il est à noter que HDPLEX publie une liste de cartes mères validées sur son site. Si comme moi vous prenez un modèle non listé, je suppose que vous n'êtes pas à l'abri de ce genre de petit désagrément.

En inversant les caloducs 3 et 4, je n'en ai plus qu'un qui dépasse. Après m'être renseigné il s'est avéré que je pouvais soit ne pas monter le quatrième, soit m'arranger pour le raccourcir, le caloduc devant cependant rester fermé (on ne peux pas juste le scier pour le raccourcir).

Téléphone arabe
Tant qu'à faire je l'ai fait transmettre, par personne interposée, à un ami qui a le matériel pour travailler des tuyaux de cuivre de petite section, pour avoir quelque chose de propre ; mais le téléphone arabe est passé par là et la pièce que j'ai récupérée était écrasée en son extrémité, du coup elle n'était plus ronde et ne rentrait plus dans les rainures latérales. Pour finir, j'ai coupé la partie écrasée et j'ai fait ressouder le bout qui avait été coupé en insérant un pas de vis en interne pour guider le tout. Un peu brutal mais ça l'a fait.

Montage aisé, ou presque

Je n'ai pas rencontré de difficulté particulière pour le montage. Il faut dire aussi que mon montage était très basique, juste un SSD, pas de carte d'extension, pas de carte vidéo.

La visserie est fournie en nombre et en qualité. J'ai pu monter et démonter certaines parties sans souci, c'est qualitatif.

J'ai pris quelques photos au fur et à mesure de l'avancement

La première étape ne présente aucune difficulté. On fixe sur la carte mère le support du bloc de refroidissement, puis on la pose sur des entretoises en fond de panier.

On enfiche le processeur et on fixe la partie inférieure du bloc de refroidissement (en cuivre).

Fixation du côté droit puis test de mise en place des caloducs. C'est là que j'ai relevé le problème mentionné plus haut.

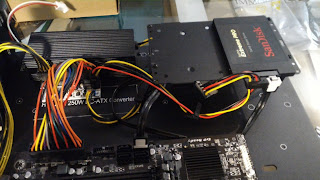
Ensuite, on met en place les deux parties de l'alimentation électrique, leur emplacement est repéré.
Mise en place des deux éléments de l'alimentation sur le fond du boitier

Je n'ai pas pu fixer le bloc d'alimentation sur les 4 trous prévus, l'ajustement n'étant pas parfait mais ce n'est pas un souci du tout, 3 vis suffisant bien. C'est une pièce qui ne subit aucune vibration, il ne peut rien lui arriver.

Fixation du bloc AC/DC
Les trous de fixation du premier puis du second bloc
Je suppose que le problème a été vu et corrigé car quand j'ai reçu un second bloc (le premier étant défectueux), j'ai vu que les pâtes de fixation ont été modifiées.


Cage disque en place
Mise en place de la cage disque et fixation du SSD

Flanc gauche
Mise en place du côté gauche et branchement de ses connecteurs
(le reset, les prises USB3, prise casque, les prises USB2)

Facade avant
Mise en place de la façade avant (amovible)
Si vous êtes observateur, vous avez du voir que le disque est fixé dans le mauvais sens sur la cage (et pas le même que sur la photo précédente). Je l'avais monté dans le mauvais sens, je m'en suis rendu compte quand j'ai voulu le brancher et que je n'avais pas accès au connecteur SATA (non mais quel crétin !)

Mise à la masse
Ne pas oublier de relier la terre à la carcasse (non mentionné dans le manuel)

L'interrupteur de la façade avant comporte deux câbles à relier à la carte mère.

Le câble avec deux fils vert et blanc est à brancher sur le connecteur "panel", sur les pins PWR+ (fil vert) et PWR- (fil blanc).

Le second connecteur avec deux câbles noir et rouge est à connecter sur un header pour ports USB2. Il utilise les pins normalement destinés à l'alimentation d'un port USB pour alimenter la lumière du connecteur en façade (les effets de lumière se configurent via des petits jumpers sur le dos de l'interrupteur).

A noter : on ne branche ni haut parleur interne, ni voyant d'activité du disque (non prévus dans le boitier conçu pour un usage HTPC).

Le câble de reset (branché sur le connecteur "panel" sur RST+ et RST-) est relié au connecteur de façade inclus dans le côté gauche.


Non, la seule difficulté, et là je dois dire qu' avec mes gros doigts maladroits j'ai eu du mal, c'est d'appliquer la pâte thermique proprement dans les rainures du boitier et du bloc de refroidissement, avec le petit outil en forme d'haltère.

L'outil est tout petit à manipuler, il serait pertinent d'avoir un bout plus gros pour faciliter la prise. La boule de l'haltère s'est désolidarisée du manche et la récupérer dans la rainure n'est pas simple, je me suis mis de la pâte plein les doigts. Bref, j'ai fait ça un peu comme un malpropre et j'ai manqué un peu de pâte du fait que j'en ai gâché.

Pour le reste, ça va tout seul.

2nd contretemps

Tout content, j'allume la bête pour un premier test et là grosse désillusion ; le bloc AC/DC produit un sifflement aigu insupportable, surtout quand on a craqué sa bourse pour une machine totalement noiseless.
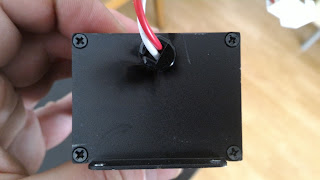
Bloc cramé
Le premier bloc qui a cramé (zoomer)
Contact pris avec le fournisseur, pas de souci, il m'en renvoie une autre sans discuter.

Finalement, le sifflement devait être lié avec un défaut quelconque car l'alimentation a fait sauter mon disjoncteur et a cramée au bout d'une journée.

Je reçois la pièce de rechange très vite, je la met en place et là que du  bonheur. La machine est totalement silencieuse.


Bon finalement j'ai donné le premier bloc à mon frère, il est électricien et avec un peu de chance il va pouvoir  le réparer et le recycler pour un autre PC qu'il veut se mettre en place.
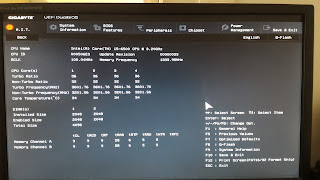
Bios
Un petit contrôle avant de refermer le dessus du boitier

Installation de l'OS, pas un long fleuve tranquille

Normalement c'est une simple formalité. Ben non, pas cette fois.

Premier souci, la clé USB bootable n'est pas détectée... Après avoir fouillé en vain les options de l'UEFI pendant un moment, et testé plein de combinaisons sans trop y croire (et sans succès), je finis par tilter qu'il faut la brancher sur un port USB2 directement connecté à la carte mère, et pas sur un port USB3 branché sur un header d'extension. Sans doute une limitation des drivers de l'UEFI. J'étais à deux doigts de désosser le graveur de DVD d'une autre machine.

Désillusion suivante, qui n'a rien à voir avec le boitier : je m'aperçois que la GPU intégrée des skylake (dernière génération des processeurs Core) n'est pas supportée par Linux... Il faut attendre la version 4.4 du noyau, et les distributions de bureau ne seront sans doute pas disponibles avec cette version du kernel avant un petit moment.

Il y a bien moyen d'activer un support expérimental, avec plus ou moins de garantie, ou d'upgrader le noyau, avec plus ou moins d'instabilité résultante du système, mais je n'ai pas envie de me prendre la tête pendant des semaines.

Je suis un peu dépité, je n'ai pas pensé à vérifier que le driver était disponible quand j'ai élaboré ma configuration mais jamais je n'aurais imaginé avoir un problème pour un composant aussi standard et mainstream, quand même sorti depuis quelques mois. Bref, Linux sur le desktop a encore des progrès à faire.

Tant pis, je reviens en Windows 10. Je récupère une licence Pro via un contrat MSDN, et roule ma poule. Contrairement à ma première installation (upgrade d'un Seven), je ne me fais pas avoir par le gros bouton "installation rapide" et je vais bien chercher le petit lien planqué pour désactiver toutes les options merdiques activées par défaut.

J'ai quand même dû m'y prendre à plusieurs fois : j'ai d'abord laissé l'installeur créer les partitions sur le disque vierge, et il m'a fait une partition système qui prend 100% du disque...

J'essaye de retailler la partition mais rien à faire, je ne peux pas la descendre à moins de 120 Go !

je refais une installation et cette fois je prend la main pour créer une partition bien taillée, et là Windows refuse de s'installer : l'installeur a créé une table de partition MBR et Windows détectant qu'il tourne sur un système UEFI réclame une table de partition GPT. NomdidjieuDeNomdidjieu !

Après quelques instants de perplexité, je reboote sur une distribution Linux live, je lance GParted (outil de gestion des partitions), je supprime toutes les partitions, je créé une table de partition GPT et rebelote. Cette fois ça passera.

En fait, je ne sais pas si c'est un bug de l'installeur Windows qui en l'absence de table de partition en créé une en MBR par défaut, ou si c'est moi qui ai fait une erreur : je ne connais pas bien cette carte mère et elle propose plusieurs modes de démarrage quand on boote sur USB, il est possible qu'il faille prendre une option démarrage UEFI et que je ne l'ai pas fait le moment venu. Ca restera une interrogation, après 3 installations je n'ai pas envie de m'en taper une quatrième, voire une cinquième, juste pour déterminer ce point. On va dire que c'est un bug de Windows (mauvaise foi quand tu nous tiens).

Le SSD de bâtard !

J'ai regardé "les tuches" hier à la TV. Pas très fin m'enfin ça passe une soirée, et j'ai retenu l'expression favorite du mongol de la famille : le "ce que tu veux" de bâtard !

Je commence à utiliser la machine, et je suis impressionné par la performance. Du coup, je fais quelques tests basiques en comparant le temps de traitement d'un très gros fichier RAR multi-volumes entre mon ancienne configuration et la nouvelle.

En passant d'un core i7 à un core i5 moins rapide en fréquence, avec la même quantité et les mêmes barrettes de mémoires, le même OS, sur SSD dans les deux cas, je divise par plus de deux mon temps de traitement (et à priori WinRAR exploite bien le multi-threading).

Il me faudra faire d'autres tests plus poussés mais d'ores et déjà je m'aperçois que je ne me suis pas trompé dans le choix de mon SSD.

Il est vraiment impressionnant de vitesse : j'ai choisi un modèle qui explosait tout dans les benchmark et je l'ai payé cher, en me sentant presque un peu coupable de me laisser convaincre par les sirènes du marketing. Mais non, c'est vraiment une bête de course.


Et le refroidissement ?

J'ai trouvé, avec un peu de difficultés, le soft idéal sous Windows 10 : Piriform Speccy. Il m'affiche dans la barre de notifications en temps réel la température du processeur. ça me rassure.

Pour le moment que du bon. En utilisation bureautique, je suis à maximum 31° (29 en idle). Ca reste stable après plusieurs jours sans éteindre la machine (qui passe en veille ceci dit).

Je n'ai pas encore lancé la machine en burn car de toute façon je ne vais pas l'utiliser pour des traitements lourds. Je ferais un update ici quand j'aurais un peu de temps, disons cette semaine, mais pour le moment, sur quelques traitements un peu plus conséquents je n'ai pas dépassé les 45°.

Conclusion

J'ai atteint mes objectifs. J'ai débranché mon ancien système qui va être désossé et réutilisé pour un NAS qui sera dans une autre pièce, et je me délecte du silence total de fonctionnement de mon petit plaisir.

Le boitier est gros et c'est normal car il n'est pas prévu du tout pour un usage bureautique (à la base c'est un boitier au format équipement hifi pour un système home-média), et c'est exactement ce qu'il me fallait car je peux le poser sous mon scanner/imprimante et ainsi ne pas perdre de place sur mon (petit) bureau.

Même si j'ai eu quelques petits soucis, je ne peux que me féliciter de la collaboration avec HDPlex, Larry l'ingénieur qui a conçu le boitier s'est toujours montré très réactif en réponse à mes divers mails et n'a pas sourcillé une seconde quand il a fallu renvoyer des pièces (dont une petite pièce que je ne trouvais pas et que j'avais probablement égarée).

Je doit faire encore quelques tests plus poussés pour vérifier le refroidissement en conditions de forte charge, mais je ne suis pas inquiet. Je ferais une mise à jour de ce post, et d'ici là je ne peux que recommander ce boitier, à condition toutefois d'être un minimum expérimenté en assemblage d'ordinateur et de lire l'anglais. Je posterais également le résultat de ces tests sur la section du forum hardware.fr dédié à la communauté du fanless en France.

02/04/2016 : Update (important)

Il y a une erreur que j'ai commise et il me semble important de le préciser car je me rends compte à la lecture des stats que l'article est pas mal consulté.

J'ai coupé un des caloducs : c'est une erreur. En effet, un gaz circule à l'intérieur qui participe au refroidissement. Donc en coupant un caloduc je lui ai retiré toute efficacité. Mon anglais limité et les échanges par mail avec l'ingénieur de chez HDPlex m'ont enduit avec de l'erreur. La préconisation était de courber le caloduc afin qu'il puisse prendre place mais en aucun cas je n'aurais du le couper. Voilà la précision est apportée, mea culpa.

Autre petit point. J'ai eu une mauvaise surprise avec la carte mère Gigabyte (en plus j'en ai acheté une deuxième pour une seconde machine). Impossible de faire fonctionner un périphérique SATA connecté en USB3 sous Windows 10. J'ai tout essayé et après moult échanges avec le support technique j'ai fini par jeter l'éponge. Peut être une mauvaise série (le support Gigabyte a monté une plateforme à l'identique et ne reproduit pas). Ils m'ont proposé de renvoyer la carte pour échange mais j'ai besoin de ma machine et je n'ai pas envie de refaire le montage des caloducs... donc tant pis, je ferais autrement et sait on jamais ça se réglera peut être tout seul avec une maj de pilotes. Au pire, je peux toujours booter sur un linux live, car bizarrement ça fonctionne parfaitement sous Linux... L'informatique quelque fois c'est quand même un peu du vaudou.

lundi 8 février 2016

La Haute Disponibilité en bref


Le cloud computing, ou plus poétiquement l'informatique dans les nuages, est un sujet d'étude incontournable pour qui souhaite comprendre l'informatique d'aujourd'hui. 

Je prépare quelques articles sur le sujet, toujours avec l'idée d'essayer d'en expliquer les ressorts de la façon simple et compréhensible par le commun des mortels.


 Et j'ai le sentiment que pour arriver à mes fins, il va me falloir déjà parler
  • de la fin : pourquoi le cloud computing, quels sont les apports attendus ?
  • des moyens : quelles sont les avancées techniques, et les modèles économiques, qui en ont favorisé l'essor
Cet article constitue un élément explicatif d'une problématique usuelle en informatique et à laquelle le cloud computing apporte une réponse formidable : il expose les notions de Haute Disponibilité que nous abrégerons en HA par la suite (High Availibility, le terme consacré). 

Il y a des pré-requis. En cas de besoin, commencez par lire la série de 3 articles sur le fonctionnement d'Internet (et des technologies réseau), et l'article d'introduction sur le hardware.

Quels sont les objectifs de la HA ?

Un ordinateur est un dispositif matériel composé pour l'essentiel de circuits électroniques mais également d'éléments mécaniques (les disques durs classiques sont composés d'un moteur, de roulements à bille, de disques, de têtes de lecture ...). Tous ces éléments sont susceptibles de tomber un panne : un composant peut surchauffer et cramer, le moteur d'un disque dur peut casser. 

La fiabilité d'une pièce peut s'exprimer par le MTBF (Mean Time Before Failure, temps moyen avant panne).


Un ordinateur héberge un système d'exploitation. Ce système d'exploitation fait fonctionner des serveurs. Ces serveurs peuvent eux même servir de support à des applications comme un sites web par exemple, 

Tous ces éléments logiciels sont susceptible de rencontrer des bogues et de dysfonctionner. Une simple erreur de programmation dans la gestion de la mémoire peut provoquer une "fuite mémoire" (de la mémoire est allouée, réservée, par le programme qui oublie ensuite de la libérer quand il n'en a plus l'usage) : inévitablement, selon la fréquence à laquelle le programme qui comporte l'erreur est appelé, la quantité de mémoire non libérée, et la quantité de mémoire sur le serveur, il arrivera un moment où il n'y en aura plus de disponible et où le système ne pourra plus répondre à de nouvelles demandes.

Enfin, rappelez vous le fonctionnement du modèle client/serveur : sans que rien ne tombe en panne, un serveur peut recevoir un volume de requêtes qui excède ses capacités de traitement, qui sont finies, et se bloquer ou devenir tellement lent que ça revient au même.

N'importe lequel de ces 3 types d'événement a pour effet de rendre le service rendu indisponible : et selon la criticité dudit service, ce peut être juste ennuyeux, comme très grave ou même dramatique quand des vies humaines sont en jeu.

Le niveau de disponibilité attendu d'un système s'exprime par le pourcentage. Un exemple issu de wikipedia sera plus simple qu'une explication laborieuse :

  • Soit une machine que l'on souhaite utiliser 12 heures par jour, mais qui tombe en panne en moyenne pendant 1 heure chaque jour et a besoin d'une demi-heure de réglages divers pour sa remise en fonctionnement. Sa disponibilité est :
\text{Ai}\ =\ \frac{\text{12 - 1 - 0,5}}{\text{12}}\ =\ \frac{\text{10,5}}{\text{12}}\  =\ \text{87,5}\ \% \!

Pour des systèmes devant tourner en permanence, on utilise parfois le terme 24/7 (24H sur 24, 7 jours sur 7).

L'objectif de la HA est de permettre d'atteindre ces niveaux de disponibilité en dépit de l'inéluctabilité de la survenance de pannes matérielles ou logicielles.

Deux angles d'attaque

La HA peut s'aborder selon deux angles :
  • La capacité de tolérance de panne ou failover est l'ensemble des mécanismes qui permettent de pallier à une panne proprement dite.
  • La capacité à monter en charge ou scalability (parfois traduit en Français par scalabilité) est l'ensemble des mécanismes qui permettent d'adapter la capacité de traitements au volume de requêtes

Failover

Le failover s'obtient principalement par la redondance des éléments matériels et logiciels : par exemple au lieu d'avoir un ordinateur, on en installe deux. Un est présent pour fournir le service (il est up), le second ne fait rien dans un premier temps. Si "on" détecte une panne du premier ordinateur, les requêtes sont redirigées vers le second serveur qui prends le relais du premier ; on dispose ainsi du temps nécessaire pour réparer le premier ordinateur et revenir à une configuration sécurisée. Si le second ordinateur tombe à nouveau en panne avant qu'on ait eu le temps de réparer le premier, on est planté. On peut alors prévoir 3 machines, ou 4, ou 5 ou ...  

Le scénario évoqué est appelé "actif/passif" (un élément actif, un ou plusieurs autres passifs). Il existe aussi des scénarios actif/actif.

On le voit la redondance a un coût qui augmente de façon exponentielle en fonction du niveau de sécurité qu'on veut obtenir (la probabilité d'avoir deux ou trois ou quatre machines en panne en léger différé ne fait que décroître tandis que le coût des matériels augmente de façon linéaire et constante).


La détection fiable de la panne du premier ordinateur (le fameux "on") est une des problématiques à résoudre. 

On aborde ici un (vaste) sujet de l'informatique : la supervision qui est l'ensemble des moyens matériels / logiciels / humains qui permettent de surveiller le bon fonctionnement des matériels et logiciels en temps réel ou quasi-réel. 

Cette supervision se fait généralement via des sondes matérielles ou logicielles  qui mesurent la "santé" d'un ordinateur. Une bonne image est celle d'un malade en salle de réanimation dans un hôpital branché sur des appareils qui surveillent sa pression artérielle, le fonctionnement de ses poumons etc. et émettent des alertes en cas de problème.


La redirection du trafic entrant (les requêtes émises par les clients) vers la machine numéro 2 (qui passe d'un rôle passif à actif)  au lieu de la machine 1 (qui passe d'un rôle passif à un rôle actif) est fréquemment effectuée grâce à des mécanismes réseau de bas niveau qui permettent d'associer le FQDN du service appelé à une adresse IP virtuelle. 

Cette IP est dite virtuelle car elle n'a aucune correspondance physique avec une carte réseau : au lieu de cela, elle est affectée dynamiquement à la machine active (qui a une carte réseau et une vraie adresse IP)


Quand la machine 1 est en panne, on redirige les requêtes sur la machine 2, et on "répare" la machine 1. Si c'est une panne logicielle, il suffit généralement de rebooter la machine. Si c'est une panne matérielle c'est beaucoup plus ennuyeux, il est parfois possible de changer rapidement une pièce défectueuse si on a du stock mais on trouve vite les limites pratiques. Du coup, la solution consiste généralement à avoir la machine complète en spare (en pièce de rechange) : ça a un coût, il faut stocker le matériel, qui peut très bien être en panne aussi ... vous commencez peut être à percevoir l'intérêt de la virtualisation ? Nous reviendrons sur ceci.

Scalability

La scalabilité se décline sous deux formes :
  • scalabilité horizontale : elle s’obtient en multipliant le nombre d’instance du service à mettre en HA et en plaçant en amont un mécanisme de répartition de charge (load-balancer)
  • scalabilité verticale : elle s’obtient par l’ajout de ressources physiques au niveau de l’infrastructure (disques durs, mémoire, processeurs etc.).

Dans le cas de la scalabilité horizontale, le FQDN du service en HA est associé à l'IP du load-balancer. 

Ce dernier se charge d'envoyer la requête à une des machines qui s'exécutent en parallèle selon un algorithme. 

Cet algorithme peut être très simple et adresser alternativement et successivement chacune des machines (on parle de round-robin) ou être plus sophistiqué et tenir compte de l'état de santé des différentes machines pour cibler celle qui est la plus en forme, et éviter d'envoyer du trafic à une machine en panne. On retrouve la nécessité de sondes pour ce cas.

C'est ce type de scalabilité qui est le plus employé. La scalabilité verticale consiste simplement à upgrader un matériel pour lui ajouter des capacités (de la mémoire, du disque, un processeur supplémentaire sur une machine multi-processeur etc.).

La scalabilité horizontale peut être gérée dynamiquement simplement en démarrant une nouvelle machine et en informant le répartiteur de charge. On peut même si on pousse l'idée plus loin, ajouter et enlever des machines automatiquement selon les besoins : c'est ce qu'on appelle l'élasticité (une notion clé des solutions cloud comme nous le verrons). Ici aussi, vous devez percevoir l'intérêt de la virtualisation : en effet, à moins d'avoir des robots ou des armées d'ouvriers, comment pourrait on installer et dé-installer dynamiquement des ordinateurs physiques ?

La scalabilité verticale conserve son intérêt. Quand on choisit un serveur chez un fournisseur, on a tout intérêt à se préoccuper de la capacité d'évolutivité de la machine en question. En effet, il ne faut pas perdre de vue que si on virtualise les moyens informatique, il faut quand même des serveurs physiques pour faire tourner les systèmes virtuels, et que ce sont eux qui vont devoir encaisser un accroissement d'activité généré par la multiplication d'ordinateurs virtuels dans le cas d'une scalabilité horizontale. Et ils deviendront à leur tour un facteur limitant si vous devez les changer ou les immobiliser pour ajouter des processeurs, des disques, des interfaces réseau etc. Les serveurs spécialisés professionnels prennent tout leur intérêt avec de fortes capacité d'extension à chaud sans interruption de service.

SPOF

Encore un acronyme comme on les aime en informatique : Single Point Of Failure. Ce terme désigne le maillon faible d'une architecture, celui qui en cas de défaillance met en panne l'ensemble du système.

Dans notre exemple précédent, on parlait de mettre un répartiteur de charge devant n serveurs pour assurer la scalabilité horizontale. 

C'est super mais que se passe il si notre répartiteur de charge tombe en panne ? On aura beau avoir 100 serveurs mega-puissants derrière, on l'aura dans le coin coin. Le répartiteur constitue ici un SPOF.

Comment améliorer les choses ?

On a deux types de répartiteurs de charges : logiciels et matériels. Préférer un répartiteur matériel améliorera les choses : ils sont extrêmement robustes et très peu susceptibles de tomber en panne : mais ça arrive quand même (et en outre ça coûte très cher). Les marques les plus connues sont F5 et Alteon

Pour supprimer le SPOF, il faudra simplement un mécanisme de failover sur le load-balancer : si on met deux répartiteurs physiques en actif/passif par exemple, les probabilités de panne seront très très très faibles (mais pas nulles, le mécanisme qui fournit l'IP virtuelle en amont peut défaillir).

Quoi d'autre ?

Dans tous les exemples ci-dessus, nous avons parlé de HA au sujet d'ordinateurs en nous focalisant sur la ressource "capacité de traitement" du système informatique, qui est assurée bien entendu par le CPU des ordinateurs (en collaboration avec la RAM).

Mais d'autres éléments sont mis en oeuvre :
- de l'espace de stockage
- des communications réseau

Dans les infrastructures de production conséquentes, les ordinateurs n'ont souvent pas de disque et la gestion des disques est effectuée sur des périphériques de stockages dédiés et accessibles via le réseau.

Différents systèmes existent : le NAS est en gros un ordinateur qui héberge un service de serveur de fichiers auquel font appel les serveurs "cpu" (dans l'idée c'est comme un partage réseau sur un ordinateur de bureau), le SAN est un mécanisme beaucoup plus sophistiqué, coûteux et performant.

Tous ces "trucs" (ordinateur, load-balancer, NAS, SAN ...) communiquent par le réseau. Or un réseau ça implique aussi du matériel : switch pour cloisonner différents réseaux virtuels (switch administrable niveau 3), routeur pour l'interconnexion à Internet ou à d'autres réseaux étendus, firewall ...

Tous ces éléments sont également amenés à être supervisés et installés dans une configuration HA car leur défaillance ou surcharge est également critique pour l'ensemble du système.

Et, oui ... ces éléments peuvent également être virtualisés (ça devient un peu compliqué).

Au niveau logiciel

J'ai parlé ici de la HA au niveau matériel et système. Mais on retrouve les mêmes concepts au niveau logiciel. Je vais ici mettre le focus sur les architectures web, et les serveurs d'application mis en oeuvre pour assurer le rendu des pages des sites web dynamiques.

De nombreux serveurs d'applications offrent des solutions pour regrouper des serveurs autonomes en ensembles cohérents, pour l'administration et le déploiement des applications, mais également pour la mise en oeuvre de la haute disponibilité : load-balancing, failover.

Les serveurs d'application JEE (plateforme Java) en particulier sont riches en ce domaine que ce soit IBM Websphere, Oracle Weblogic, Redhat Jboss ...

Les architectures web ont cependant longtemps présentées une contrainte particulière : la gestion d'une session utilisateur se faisant dans la mémoire du serveur sur lequel l'utilisateur s'est initialement authentifié, le load-balancing qui a comme conséquence de le diriger vers un serveur de façon aléatoire ne peut pas être mis en oeuvre. Et si le serveur dans lequel sa session est gérée redémarre, les données de sa session sont perdues (en tant qu'utilisateur, vous perdez vos données mémorisées et vous devez vous authentifier à nouveau).

La session, pour les non spécialistes du web, c'est simplement la mémorisation des données spécifiques à un internaute entre deux requêtes, comme par exemple la liste de son panier d'achat (rappelons que le protocole http est sans état).

Pour pallier à ces deux soucis, il existe différentes solutions que j'expose rapidement :
  • on configure le load-balancer dans un mode particulier appelé "affinité de session" (sticky mode) qui permet de toujours rediriger un même utilisateur sur le même serveur Cependant, si ça permet de concilier load-balancing et session serveur, ça ne couvre pas le failover.
  • on configure le serveur d'application pour qu'il enregistre les données de session en base de données (sessions persistantes). On a ainsi le load-balancing et le failover mais les inconvénients sont très nombreux : le stockage des données de session en base est très lent et implique l'investissement dans du matériel très coûteux pour héberger le SGBDR, il y a des contraintes de programmation, on introduit un SPOF au niveau du SGBDR et si on veut l'éliminer il faut passer par des solutions techniques (réplication) également très coûteuses et qui ne sont pas sans inconvénient, en particulier au niveau de l'exploitation
  • on peut mettre en oeuvre des solutions qui permettent de stocker la session en mémoire mais de façon répartie, rapidement, avec de la redondance qui apporte le failover. C'est sans doute la meilleure solution mais ça implique l'achat de licences pour ces solutions (et leur apprentissage). A réserver pour les gros sites, avec des investisseurs au portefeuille garni.

Ceci étant dis, le mieux est probablement de bâtir une architecture dans laquelle on n'a pas de gestion de la session utilisateur côté serveur.

On qualifie ces architectures de stateless (sans état) et elles constituent l'état de l'art actuel, du moins à humble avis.

Ces architectures sont généralement basées sur des communications asynchrones en http effectuées par du code javascript s'exécutant dans le navigateur (technique de base du web 2.0, parfois encore appelé ajax). On parle de style d'architecture REST (bien que souvent, on soit plutôt sur du simple RPC over HTTP avec de la sérialisation au format JSON).

Explications du jargon : RPC ça veut juste dire "appel de procédure distante" (Remote Procedure Call) ce qui est le cas puisqu'on a un code javascript sur le client qui appelle une procédure sur le serveur ; over HTTP qu'on utilise le protocole HTTP pour faire cet appel de procédure (donc tout bêtement qu'on fait une requête http) : JSON, c'est "Javascript Notation", un format de sérialisation de données, ce qui en bon Français veut juste dire une façon de représenter des données de façon textuelle (dans un format qui en outre est directement compréhensible par un interpréteur EcmaScript, donc par javascript). Ces éléments sont présents et essentiels dans la définition d'une architecture REST qui nécessite cependant le respect d'autres points souvent ignorés par des développeurs qui font du coup du "presque-REST" (la confusion est fréquente).

Ce style d'architecture rencontre un grand engouement actuellement, bien au delà des applications web d'ailleurs, et combiné avec les outils et pratiques DevOps et les techniques de virtualisation moderne remet au gout du jour le SOA dans une variante désormais appelée micro-services.

Explications du jargon : SOA (Service Oriented Architecture) est un style d'architecture répartie qui a été très à la mode malgré une lourdeur certaine dans ses premières implémentations (SOAP pour ceux à qui ça parle), et qui revient actuellement sur le devant de la scène grâce à ce "nouveau" (en fait rien de nouveau pour les vieux briscards, mais bon passons) mode de mise en oeuvre basé sur REST, beaucoup plus simple et léger. Cette facilité d'implémentation, plus l'essor du mouvement DevOps qui rapproche les équipes de développements et d'exploitation et met l'accent sur des solutions techniques légères (comparativement aux serveurs d'application JEE cités plus haut qui sont des usines à gaz redoutables) favorise donc une nouvelle "saveur" de SOA rebaptisé "micro-services" pour faire oublier aux DSI les millions engloutis dans des projets SOA ayant explosé en vol (en partie du fait de la lourdeur des choix techniques initiaux, bien que les écueils de ces projets étaient bien souvent liés à des problèmes organisationnels).

Oui, mais si on a absolument besoin d'un session du fait des fonctionnalités et de l'ergonomie (un panier d'achat pour un site ecommerce par exemple) ? Hé bien, la session est gérée côté client. A un moment, il faudra bien renvoyer le paquet de données au serveur mais ça ne devrait pas constituer un facteur limitant dans 99% des cas. Et les frameworks javascript modernes facilitent désormais la programmation de ce genre de cas.

Comme on le voit, les choix d'implémentations ont donc aussi un impact fort sur la facilité plus ou moins grande à mettre en oeuvre une architecte HA.

Pour le fun : virtual hosting

Juste pour le fun. Si vous avez compris tout ceci, vous devez pouvoir comprendre comment fonctionne le virtual hosting dans un serveur http.

Le virtual hosting est la capacité pour un serveur http à héberger non pas un, non pas deux, non pas trois mais un nombre potentiellement très élevé de sites web. C'est la technique utilisée par les hébergeurs web pour leurs offres d'hébergement mutualisé (un serveur web partagé par n sites).

Mais comment est ce possible puisque chaque site web a un FQDN différent ? Et que chaque FQDN est censé pointer sur son serveur web dédié, via son IP spécifique ?

Hé bien, tous les noms de machines pointent sur la même adresse IP, celle du serveur web. C'est donc le serveur Web qui reçoit toutes les requêtes pour tous les sites. Exactement comme notre load-balancer tout à l'heure. D'ailleurs, on peut configurer un serveur web en tant que load-balancer, c'est l'alternative gratuite à l'utilisation des coûteux boitiers F5./Alteon évoqués (qui sont par contre infiniment plus performants vu que l'algorithme est implémenté au niveau matériel). Ici, le serveur web est configuré en reverse-proxy : comme son nom l'indique il fait l'inverse de ce que fait un proxy (qui rappelons le, reçoit les requêtes en sortie et les réémet) : il reçoit les requêtes en entrée et les adresse vers le bon destinataire en se basant sur le nom (FQDN) avec lequel il a été appelé. Sa configuration consiste à activer la fonctionnalité et à décrire les règles de mise en correspondance entre un FQDN et un répertoire racine d'un site web statique ou une adresse et un protocole de communication d'un serveur d'application pour un site web dynamique.

J'avais évoqué dans l'article sur le fonctionnement d'Internet la possibilité d'héberger plusieurs serveurs web à son domicile malgré le fait que notre box Internet ne dispose que d'une seule IP publique. Hé bien, c'est à cette technique que je faisais allusion : une règle de NAT au niveau de la box pour envoyer le trafic entrant sur le port 80 vers votre serveur http hébergé en interne et qui met en oeuvre du virtual hosting pour relayer le trafic vers n serveurs (http ou serveur d'application) de votre réseau interne. Vous voilà hébergeur !

Conclusion

Bon, j'ai écrit tout ça d'une traite après une nuit blanche (je vais me relire un petit coup quand même). Je n'avais rien produit depuis un moment, je suis en train de voir pour démarrer une activité en indépendant et je passe un temps insensé à chercher les infos à jour sur les mécanismes fiscaux et de protection sociale... bien plus compliqué que l'informatique croyez moi ! Et j'ai fait des études de gestion (j'ose pas imaginer la galère pour celui qui n'y connait rien).

La suite c'est de parler rapidement des solutions de virtualisation, puis de décrire les modèles économiques  du cloud computing (SAAS, PAAS, IAAS et même DAAS), et rebondir ensuite sur les solutions techniques de gestion de cloud et le mouvement/outils DevOps. J'ai toute la trame en tête , faudra juste que je prenne le temps. 

vendredi 11 décembre 2015

Les bases d'Internet, en images

Tout est dans le titre : en complément aux articles précédents "les bases en informatique pour comprendre Internet", voici un slideware pour creuser un peu plus le sujet, en particulier DHCP et DNS.

Vu que html et javascript ne sont pas des langages qui me passionnent (doux euphémisme), je ne me suis pas cassé la binette à intégrer le slideware à la plateforme de blogging (de toute façon je ne suis pas sur que ça aurait donné un super résultat vu que j'ai dessiné les slides avec une surface d'affichage plein écran sur du 24").

Donc, j'ai fait une simple intégration par lien html externe. L'accès au slideware se fait donc en cliquant sur ce lien.

Have fun 


samedi 5 décembre 2015

PC Desktop Fanless 2/3 - La réception

Suite de mes aventures au pays du fanless. 

Le facteur a sonné à ma porte ce samedi dernier et m'a livré le magnifique boitier HDPLEX H5 (2nde génération), c'est un peu noël avant l'heure. 

J'avais déjà reçu le processeur, la carte mère et le SSD depuis quelques jours. Après une partie de chasse aux prix, j'avais fait mes emplettes chez RueDuCommerce pour le processeur et GrosBill pour le reste. La RAM est recyclée d'un ancien PC (c'est pour ça que j'ai pris une carte mère qui supporte la DDR3 et pas la DDR4).

Vous pouvez cliquer sur les photos pour les afficher en full screen et en HD.

ça y est la bête est arrivée

Premier constat, tout est extrêmement bien emballé et protégé, c'est du cousu main et de la grande qualité. C'est pas donné mais on en a pour son argent.

Au fond à gauche, c'est la moitié de l'alimentation électrique, le bloc DC/ATX qui reçoit le courant continu et dont sortent les différents câbles qui vont alimenter la carte mère, les disques etc.

Au fond à droite, c'est la façade avant du boitier.

Au milieu à gauche le dissipateur thermique pour le processeur

Au milieu à droite, les différentes pièces internes (incluant les connecteurs de la façade latérale). En avant plan, on a les plaques qui constituent le reste du boitier à plat en pièces détachées, chaque pièce étant protégée par une épaisse feuille de mousse, et le tout emballé dans un gros bloc de mousse dure.

La carte mère, le SSD et le processeur sont sur la droite. J'ai détaillé ces composants dans le premier article de cette série.

Il manque une pièce : la première partie du bloc d'alimentation électrique, celle qui reçoit le courant alternatif et le convertit en courant continu. 

J'ai fais un mail à HDPLEX pour signaler le problème, et j'ai eu un retour dans la foulée ; la pièce est expédiée à part et l'expédition est en cours. Avec le numéro de tracking fourni dans la réponse, j'ai pu voir qu'elle était cette fois ci envoyée de Hong Kong (probablement un souci de stock sur le dépôt Européen situé en Allemagne d'où provenaient le reste des pièces) par avion, et actuellement à Paris avant de m'être envoyée sur Reims. Ils ne regardent pas à la dépense chez HDPLEX.

Bon, c'est juste un petit désagrément temporaire.


l'alimentation électrique, le bloc DC/ATX

Tout est là, le bloc proprement dît dans son emballage anti-statique, les deux câbles pour l'alimentation de la carte mère, le câble avec une prise Molex et 3 prises SATA pour l'alimentation des périphériques. 

Il y a en sus deux câbles dont je n'aurais pas l'usage et qui servent à priori dans le cas où on utilise un boitier d'alimentation externe du type de ceux qu'on trouve avec les ordinateurs portables (deux câbles car deux types de connecteurs se rencontrent sur le marché). Je n'en aurais pas l'usage car j'ai choisi un bloc d'alimentation interne.

Zoom sur le bloc proprement dît (image provenant du site HDPLEX).

Les spécifications détaillées sont disponibles chez le fabricant.


Le boitier : fond, dessus, côtés

A l'avant plan, le fond : on remarque la qualité de la réalisation et le soin avec lequel sont tracés les différents repères.

A l'arrière plan, le dessus. Au fond à gauche un des deux côtés. Quelle beauté ! 

La particularité de ce boitier conçu pour les solutions fanless est que les côtés participent à la dissipation de la chaleur, d'où les ailettes et la matière.

Le boitier, la façade avant

La façade avant avec le trou destiné au positionnement de l'interrupteur.

Sur la gauche, le composant électronique avec 5 petits poussoirs activés par l'interrupteur, puis l'interrupteur de série (il est possible de le faire personnaliser avec la gravure au laser du motif de son choix), et la charnière de la façade.

Encore une fois, c'est emballé avec grand soin, avec un plastique dur moulé sur mesure.


Le boitier, le bazar interne

Ici encore, tout est protégé par un capot en plastique dur moulé sur mesure.

On voit sur la droite le bloc de connecteurs externes (usb3, usb2, connecteur pour alimenter un périphérique externe de son choix depuis l'alimentation interne, prise casque, bouton de reset) et les câbles (ou la nappe pour la connectique usb3) qui vont servir à raccorder tout ça à la carte mère.

Au milieu, on a la fiche qui servira à raccorder le PC au réseau électrique (partie femelle en haut) et au bloc d'alimentation (partie mâle en bas qui se branchera sur la pièce qui me manque, le convertisseur DC/AC). On voit les 4 patins qui se placeront sous le boitier. Puis, toute la visserie, les pièces mobiles pour obturer/ouvrir les ouvertures à l'arrière du boitier selon qu'on a ou pas branché des cartes d'extension sur les ports PCI(-E) de la carte mère, le support de disque etc.

On peut remarquer que les outils pour le montage sont fournis, délicate attention.

Le système de refroidissement

Là on touche au grandiose.

Alors on voit le bloc en cuivre qui va être posé sur le processeur pour en aspirer la chaleur (avec sa pâte thermique pré-appliquée). 

Puis le bloc avec des ailettes en bas à gauche, qui doit être en aluminium je pense, et qui va conduire la chaleur vers les tuyaux coudés en cuivre (qui seront clipsés sous le bloc en alu).

Les tuyaux en cuivre (caloducs) se chargeront quand à eux de promener  la chaleur et donc de la dissiper au sein du boitier, pour finalement la conduire sur les côtés du boitier qui finiront de l'absorber (le métal va absorber la chaleur sur toute sa surface et va bénéficier de l'air plus frais à l'extérieur du boitier). Si vous avez bien compris le principe, en plus d'avoir un ordinateur fanless, on a un radiateur, elle est pas belle la vie ! Ceci dis, je vous rassure c'est une boutade, le boitier ne chauffera pas assez pour constituer une gêne (mais on s'en assurera par quelques tests).

On peut remarque que la pâte thermique est fournie. A priori c'est la référence Z5 du fabricant Deep Cool, je ne la connais pas mais à priori, après quelques recherches sur le web, c'est un produit d'excellente qualité. Un benchmark sur harwaresecrets, mon site préféré, la classe très bien : c'est ici.

Le reste de l'alimentation électrique (bloc AC/DC)

Bon la pièce n'est pas là encore, mais je ne doute pas de la recevoir un peu plus tard. J'ai contacté HDPlex qui m'a rapidement rassuré, la pièce est en cours d'expédition.

Je met une photo prise sur le site HDPLEX.

Les spécifications détaillées sont disponible ici.


Et un premier upgrade en vue

Le boitier est tout nouveau et je fait partie du premier lot d'utilisateurs, mais néanmoins je ne suis pas le premier : HDPlex a eu des retours terrain des premiers assemblages et en a tenu compte pour améliorer quelques bricoles : la charnière de la façade avant, le bloc de prises façade (sur le côté).

J'ai eu un mail ce matin, les mises à jour de ces pièces vont m'être envoyées gracieusement ; du coup, plutôt que de re-démonter la machine, je vais attendre de les réceptionner.

Moi je trouve la démarche carrément honnête et professionnelle ; j'apprécie le geste.


Conclusion (temporaire)

Bon, j'espère recevoir rapidement la pièce qui manque et l'upgrade. Ensuite, y a plus qu'à...

Habituellement j'assemble des PC classiques, ici il y a un peu plus de travail :
  • il faut assembler le boitier fourni en pièces détachées
  • il faut assembler le système d'évacuation de la chaleur
  • l'alimentation électrique est en deux parties indépendantes (voire 3 si on compte le câble qui fournit la connectique externe ; l'alimentation électrique est pensée de façon très modulaire)


Mais rien de bien compliqué à priori,c'est du mécano, donc plutôt fun. Et le manuel fourni est de super qualité, même si mon anglais très imparfait me joue des tours.

A suivre

Qu'est ce qu'un programme 2/2

Dans un premier article, nous avons parlé des programmes tels qu'ils étaient conçus à l'origine de l'informatique, c'est à dire du code machine produit par simple traduction d'un code source en code binaire (dans le cas de l'assembleur) ou de façon plus sophistiquée par compilation d'un code source en code binaire (dans le cas des langages compilés).

Nous allons maintenant voir qu'il existe d'autres possibilités.

Cet article est le second d'une série de deux. La lecture du premier est un pré-requis.
- Qu'est ce qu'un programme 1/2

Nous allons parler de langages utilisés dans le contexte du web, si vous ne maîtrisez pas les fondamentaux de l'architecture du web, je vous recommande de lire cette série d'articles :
Les bases pour comprendre le Web - Episode 1
Les bases pour comprendre le Web - Episode 2
Les bases pour comprendre le Web - Episode 3


Pourquoi ces autres possibilités ?

Assembleur : vraiment trop relou

Nous avons vu que l'assembleur était tout simplement un truc de malade : pour pouvoir programmer en assembleur, il faut savoir comment fonctionne le processeur ce qui est très compliqué ; du coup comme le langage est de très bas niveau, il faut écrire des centaines de lignes pour faire de choses très simples. 

On en réserve donc l'usage à des cas très spécifiques, et ça reste une affaire de spécialiste (ou de curieux passionné).

Langage compilé : encore trop compliqué pour la ménagère de 50 ans

Les langages compilés sont donc apparus pour permettre de simplifier la programmation : il n'y a plus besoin de connaître le fonctionnement du processeur ; le langage est de plus haut niveau et propose des instructions qui sont plus évoluées en ce sens qu'elles nous permettent plus directement de faire ce que l'on veut sans se soucier de la façon dont le processeur va faire (ou plus précisément de la façon dont le compilateur va traduire notre instruction de haut niveau en dizaines ou centaines d'instruction en code machine).

Donc vous me direz que tout est bien. Mais en fait non. 

L'utilisation d'un langage compilé nécessite toujours de comprendre, certes de façon beaucoup moins pointue, un certain nombre de mécanismes internes liés à l'électronique mise en oeuvre ; pour être plus précis, le développeur doit toujours se soucier de l'utilisation de la mémoire vive (RAM).

Tout programme manipule des données, et ces données sont lues et écrites dans la mémoire vive. La mémoire vive ce sont des composants électroniques qui comportent pleins de petits casiers dans lesquels le processeur range les données pour les retrouver quand il en a besoin. Chaque casier à une adresse précise qui permet de le référencer. 

Le programmeur dispose d'une abstraction pour ces cases en mémoire : ce sont les variables. Pour chaque donnée qu'il doit gérer, le programmeur déclare une variable (montantHT, tauxTVA, ageDuCapitaine) qu'il peut ensuite manipuler simplement. Or, une variable c'est tout simplement l'abstraction de l'adresse d'une case en mémoire. 

Mais où ça devient un peu compliqué, c'est qu'une case en mémoire a une taille fixe tandis que les données manipulées dans un programme ont des tailles différentes et/ou variables. Par exemple, un age est un chiffre compris entre 0 et 120 (soyons optimistes) et tiendra dans une seule case, par contre un nom a une taille potentiellement beaucoup plus grande et nécessitera entre une et deux cases par lettre (selon qu'on gère ou non les alphabets internationaux).

La conséquence de ceci, c'est qu'il faut avoir conscience de la taille occupée en mémoire par chaque type de données (par exemple pour chaque type numérique : entier signé, entier non signé, nombre à décimale, sur telle ou telle plage de valeurs possible ...). De plus, un programme ne peut généralement pas connaître à l'avance toutes les variables qu'il doit utiliser car cela va dépendre des interactions avec l'utilisateur du programme (par exemple de la quantité de données qu'il va saisir au clavier) ; du coup, le programme doit réserver dynamiquement (à l'exécution) des plages de la mémoire pour pouvoir y stocker les données saisies. Et ce n'est pas tout, une fois que la variable n'est plus nécessaire, il faut libérer la réservation afin que les cases en mémoire soient à nouveau disponibles pour un prochain usage, faute de quoi la mémoire étant en quantité limitée elle sera totalement utilisée et votre programme ne pourra pas continuer à fonctionner ; il plantera purement avec un joli message du genre "out of memory / mémoire insuffisante".

Cette gestion de la mémoire est délicate et constitue la principale source de bugs dans les programmes. Elle implique un minimum de compréhension du fonctionnement interne d'un ordinateur et donc de formation (et énormément de rigueur). 

De ce fait, les langages compilés sont généralement des outils réservés à des professionnels aguerris, et ne sont pas vraiment accessible à un individu lamda.

Langage compilé : outillage pénible

Imaginons un peu que nous voulions essayer d'écrire un programme pour réaliser une idée quelconque. Déjà, il va falloir écrire le programme avec un éditeur de texte, bon ça c'est de toute façon inévitable. Ensuite, il va falloir le compiler avec un premier outil, le compilateur. Ensuite, il va falloir lancer l'édition de lien avec le linker. Enfin, nous aurons un exécutable que nous pourrons lancer pour voir comment ça marche. Et si ça fait pas que qu'on voulait, ce qui est le cas dans 99 % au début, il faut modifier le code source, recompiler etc.

Première précision : lancer un compilateur ou un linker, c'est pas forcément simple : il peut y avoir des quantités de paramètres très techniques à préciser.

Seconde précision : une compilation ou une édition de lien ce n'est pas immédiat. Et selon la taille du code source ou le nombre de librairies externes à linker ça peut prendre pas mal de temps.

Bref, tout ça pour dire que de l'idée à la réalisation, il y a un certain nombre d'étapes et que ce n'est pas une solution idéale quand on veut tester rapidement des idées. Et on voudrait bien aller plus vite et se passer de toutes ces étapes.

Un dernier mot : la situation décrite ci-dessus n'est plus la situation actuelle. Aujourd'hui, on dispose d'IDE (Integrated Development Environment) qui combinent tous les outils en un et en facilitent énormément l'utilisation. En outre, les progrès des compilateurs, plus la considérable augmentation de la puissance des processeurs depuis 30 ans, font qu'aujourd'hui on peut faire du prototypage rapide d'idées avec des langages compilés. Mais ce n'était pas le cas à une époque.


Principes / avantages / inconvénients

Principe

Vu que le processeur est trop crétin pour comprendre ce qu'on lui dit (c'est toujours ce que disent les crétins incapables de se faire comprendre), et que Monsieur X est bien trop important pour s'abaisser à apprendre sa langue, il va recruter un domestique qui se chargera de l'intendance : on lui donnera nos ordres et il se démerdera avec le petit personnel (le processeur et la ram).

Bien sur, le domestique étant de basse extraction, il ne parlera pas notre langage châtié, mais l'effort pour se faire comprendre sera moindre, il faudra juste s'abaisser à son niveau.

Bon, ça c'était une image à la sauce grand siècle. Plus concrètement, on ne va plus écrire un programme dans le langage du processeur (plus ou moins indirectement, cf assembleur/compilateur), mais dans un autre langage qui sera compris par un programme chargé de l'exécuter. 

Ce programme saura faire un certain nombre de choses et aura donc un jeu d'instructions, comme le processeur, mais ce seront des instructions beaucoup plus simples et compréhensibles ; en outre, on n'aura plus à se soucier de la mémoire (enfin presque).

Avantages

Le premier avantage, c'est la simplicité du langage. Enfin, on a un langage accessible au plus grand nombre, sans devoir étudier pendant des semaines, sans se prendre trop la tête.

Le second avantage, c'est la facilité d'utilisation. Plus besoin de passer par une lourde phase de compilation, aussitôt le code est il écrit qu'on peut le tester pour voir ce que ça donne et ajuster en conséquence.

Le troisième avantage, c'est la portabilité du programme. La portabilité c'est la capacité à utiliser notre programme sur une machine avec un autre système d'exploitation, ou carrément sur une machine avec une autre architecture processeur. En effet, comme on s'adresse à un programme intermédiaire, il suffira que ce programme existe sur différents OS et matériels pour que notre programme fonctionne partout. Elle est pas belle la vie ?

Inconvénients

Comme toujours, les inconvénients découlent des avantages.

Vu qu'on a un intermédiaire entre nous et le processeur, l'exécution du programme est beaucoup moins rapide que dans le cas d'un langage compilé. Mais cet inconvénient est à relativiser pour deux raisons. Déjà, on n'a pas toujours besoin de vitesse : un programme peut se traîner sans que ce soit gênant, et un programme qui fait peu de calcul et beaucoup d'entrées/sorties avec des périphériques qui sont lents par nature (beaucoup de lecture/écriture de données sur disque par exemple) sera peu ralenti par rapport à une version compilée. Ensuite, les processeurs d'aujourd'hui sont tellement rapide qu'on arrive quand même à des vitesses satisfaisantes. Et pour finir, la plupart des outils actuels incorporent des optimisations de compilation à la volée (à l'exécution, on parle de compilation JIT, Just In Time) qui leur permettent d’accélérer grandement leur vitesse (le meilleur exemple étant le javascript).

Pour ma part, je dirais que le principal inconvénient vient du fait que ces langages sont conçus pour être accessibles à tout le monde, ils sont trop démocratiques en quelque sorte. Pour ce faire, leurs concepteurs ont du faire des choix et sacrifier des possibilités avancées pourtant indispensables pour optimiser ou structurer proprement un programme. Et en cachant la complexité, ils gênent aussi la possibilité de comprendre leur fonctionnement interne et la façon d'optimiser l'utilisation de la mémoire, ce qui est une gêne pour les développeurs professionnels soucieux de qualité. Une fois encore, ceci est à relativiser en fonction de la criticité des applications développées (en gros, pour une application pas essentielle et qui n'évoluera pas beaucoup, on se fout qu'elle soit mal optimisée et non maintenable tant qu'elle coûte 3 fois moins cher à produire), et du coût toujours en baisse de la mémoire (acheter de la mémoire coûte moins cher que d'en optimiser l'usage par les programmes).

On est ici en plein sur un conflit de génération entre informaticiens d'antan soucieux d'économiser les ressources et pointus techniquement, et informaticiens d'aujourd'hui qui se foutent royalement de comment ça marche tant que ça répond rapidement à leur besoin.

Ajoutons au passage, en ces jours de COP21, qu'on se soucie aujourd'hui d'écologie en informatique, et que l'efficacité d'un programme qui va moins solliciter le matériel, et donc moins consommer d'électricité, et donc moins polluer est devenue un sujet.

Les solutions

Les langages interprétés.

Une application directe des principes expliqués ci-avant. On a un programme, appelé "interpréteur"  (ou runtime, ou moteur d'exécution) qui va lire le code source et l'exécuter directement.

Le plus connu est le Basic, un langage pour débutants. Ceci dit, la plupart des langages Basic modernes sont aujourd'hui compilés.

Non aujourd'hui, si il faut parler de langage interprété, le plus répandu est sans doute le Javascript utilisé pour dynamiser les pages web. Ou le PHP utilisé pour le plus grand nombre de sites web sur la planète.

Le javascript devient de plus en plus performant grâce au fait que les moteurs js incorporent des techniques de compilation à la volée (JIT). Le principe de la compilation JIT est que l'interpréteur analyse le code ; quand il détecte des sections qui vont être appelées de nombreuses fois, il fait un calcul pour voir si il sera plus intéressant de supporter le coût d'une compilation qui surviendra une seule fois et permettra d'exécuter le code plus vite, plutôt que de l'interpréter. On a ainsi le meilleur des deux mondes, mais ça reste quand même moins rapide qu'un programme compilé.

PHP vient de sortir en version 7 et intègre également des mécanismes JIT ce qui lui permet d'aller 2X plus vite (que la version précédente, la v5, cherchez pas la v6 elle n'existe pas) ; et vu que 50% environ des sites web dans le monde sont écrits en PHP et qu'ils devraient migrer facilement sur cette version, le web mondial va accélérer en 2016 et 2017. Classe !


Les machines virtuelles

Alors une machine virtuelle, c'est un programme qui simule de façon plus ou moins complète un ordinateur. 

Si les plateformes techniques de virtualisation permettent de simuler un ordinateur au complet avec toute son électronique, nous nous intéresserons ici uniquement aux programmes qui simulent le fonctionnement d'un processeur et que nous appellerons "machine virtuelle". On peut d'ailleurs voir ces solutions assez anciennes comme les précurseurs des solutions de virtualisation actuelles qui sont à l'origine de l'essor de l'informatique dans le cloud.

Alors une machine virtuelle simule un processeur : elle a donc une architecture et à ce titre un jeu d'instruction. Et donc, on peut écrire des programmes qui vont être compilés dans ce jeu d'instruction, ou même pourquoi pas interprétés (même si à la base, ça n'a pas été conçu dans cet esprit).

Alors, on revient à nouveau à de la compilation. Quel avantage du coup ? Hé bien, ce processeur virtuel est plus simple et la compilation de code source beaucoup plus rapide que quand on compile pour un vrai processeur. On ne parle d'ailleurs normalement pas de code binaire pour le résultat final mais de p-code.

Mais les vrais avantages sont ailleurs. Ces processeurs virtuels prennent en charge une partie des tâches habituellement dévolues au programmeur, et en particulier la gestion de la mémoire. Un mécanisme appelé ramasse-miette (garbage collector) gère automatiquement le fait de libérer la mémoire qui n'est plus utilisée ce qui est un progrès considérable. Les développeurs n'ont plus d'accès direct à la mémoire et ne peuvent plus faire d'erreur au niveau des allocations mémoire (qui sont gérées par le processeur d'après les demandes simplifiées faites par les programmeurs).

Ce qui est amusant c'est que ces machines virtuelles font également usage de compilation JIT pour améliorer leur vitesse d'exécution. Mais alors que ces techniques sont récemment adoptées par les interpréteurs javascript, elles sont développées depuis au moins une quinzaine d'années.

Comme pour les interpréteurs on a la possibilité d'avoir du code portable entre OS/architectures processeurs dès lors que la machine virtuelle existe sur les environnements cibles.

Sur les 3 technologies principales utilisées aujourd'hui pour le Web, deux sont basées sur une machine virtuelle : Dot Net de Microsoft et Java de Oracle (anciennement Sun), la troisième étant PHP qui est interprété (au sein du serveur HTTP).

Microsoft et Oracle utilisent la virtualisation dans des objectifs différents. 

Microsoft n'a pas porté sa machine virtuelle, appelée CLR (Common Language Runtime, moteur d'exécution commun pour les langages), sur d'autres OS que les Windows ni à priori (suis pas un spécialiste Microsoft) sur d'autres architectures processeur que x86/x64 (à voir si la plateforme DotNet est supportée sur Windows RT, la version de Windows pour processeurs ARM). Mais Microsoft permet aux développeurs d'écrire leur code source dans de nombreux langages différents et de les compiler en p-code CLR ; ainsi le développeur peut choisir le langage qui supporte le paradigme qu'il préfère ou celui dont il préfère le langage pour des raisons de convenance personnelle. C# est le langage objet de la plateforme DotNet et il est le plus moderne, mais il est possible d'utiliser des version Microsoft de Basic par exemple pour les développeurs moins aguerris.

Oracle pour sa part a porté sa machine virtuelle appelée JVM (Java Virtual Machine), ou permis à d'autres de le faire en publiant les spécifications et en fournissant des outils de certification, sur à peu près tous les OS et architectures processeurs existants. Mais Oracle ne fournit qu'un seul langage (avec son compilateur et tout le nécessaire) pour développer sur le JVM : le langage Java.

Le fait que le langage Java soit extrêmement portable explique le fait qu'au début du Web de nombreux sites utilisaient des Applets. Les Applets sont des composants développés en Java et qui sont envoyés par le serveur Http avec les pages web qui les embarquent. Ils sont exécutés sur le poste client qui doit bien sur disposer d'une JVM. Pour diverses raisons, cette technologie est aujourd'hui tombée en désuétude, remplacée par le javascript (interprété, l'interpréteur est embarqué dans le navigateur, pas besoin d'installer un JRE - Java Runtime Environment, environnement d'exécuton Java - sur le poste client en plus du navigateur. Le JRE inclut la JVM).

Le langage Java est un langage Objet. Pour programmer en Java, il faut donc maîtriser le paradigme Objet ce qui fait de cette plateforme un outil plutôt réservé aux professionnels (le langage Java est très simple mais le mode de pensée Objet nécessite un long apprentissage). Mais depuis quelques années, on voit foisonner divers langages qui peuvent se compiler en p-code exécutable par la JVM (on utilise en général le terme bytecode même si il peut être source de confusion) et qui améliorent le langage Java (un peu trop académique, verbeux et peu productif) ou permettent le support d'autres paradigmes (simple scripting, programmation fonctionnelle) : Jython d'IBM (Pyton compilé), Scala (paradigme fonctionnel), Ruby, Groovy... Certains de ces outils permettent d'interpréter du code à la volée (sans passer par la phase de compilation).


Conclusion

Voila pour ce rapide tour d'horizon. 

On peut constater que chaque progrès sert de base au progrès suivant, et que quelquefois des idées anciennes laissées de côté reprennent de l'intérêt en fonction de l'évolution des technologies.

L'informatique est aujourd'hui un métier de masse ; des écoles d'ingénieurs de qualité très variable forment à tour de bras des armées de développeurs pour alimenter l'appétit vorace des sociétés de service en chair fraîche. Bien souvent ces développeurs sont formés sur une technologie pour être directement employables et n'ont pas forcément conscience de l'ensembles des possibilités. Espérons que ceci changera car ces jeunes trop vite formés et parfois peu intéressés par le métier, simplement attirés par le mirage d'un gros salaire et d'un premier emploi facile à décrocher, décrocheront rapidement pour une partie non négligeable et iront grossir le flot des informaticiens chômeurs.